Week 8 - Semantic Part 2 - Type Checking
语义分析-解析ArrayType
到目前为止,我们已经掌握了进行语义动作所需的全部前置知识。现在可以开始实际操作。在这里,我们仅做简单示例,手把手带你完成几个基本的语义分析任务,并演示如何使用符号表,剩余部分需要你自行练习。
这里我们使用 Listener 模式进行语义分析。当然,你也可以使用 Visitor 来完成相同的工作(例如你已有的 Lab6Visitor ),我们鼓励你进行尝试。
本文所有规则名、token 名均以当前
Splc.g4为准。
本次实验的源代码下载地址:
如果你之前已经下载过Lab6,可以执行下面的命令更新:
先看与本节相关的文法(已支持数组):
globalDef
    : specifier Identifier LPAREN funcArgs RPAREN LBRACE statement* RBRACE   // 函数定义
    | specifier varDec SEMI                                               // 全局变量/数组
    ;

varDec
    : Identifier
    | varDec LBRACK NUMBER RBRACK
    ;

specifier
    : INT | CHAR | VOID
    ;

statement
    : LBRACE statement* RBRACE                        # CombineStmt   // 复合语句(新作用域)
    | specifier varDec (ASSIGN expression)? SEMI      # LocalVariableStmt  // 局部变量/数组
    | RETURN expression SEMI                          # ReturnStmt
    | expression SEMI                                 # ExpressionStmt
    ;
注意:SPLC 一条变量声明语句 只声明一个变量 。
我们先完成最基本的变量定义与变量查询。
由于我们使用 Listener 来进行语义检查,首先创建一个新类 SyntaxListener,继承自 SplcBaseListener。然后给这个类定义两个成员变量:
globalScope表示根作用域;currentScope表示当前所在的作用域,在遍历语法树时会动态改变。
1. 进入/退出作用域
# CombineStmt 复合语句(一对花括号)定义了一个新作用域,例如:
对应文法:
Listener设计方式: 因为该备选带了标签,Listener 会生成 enterCombineStmt / exitCombineStmt。在 enter 中创建新作用域,在 exit 中恢复外层作用域:
@Override
    public void enterCombineStmt(SplcParser.CombineStmtContext ctx) {
        this.currentScope = new Scope(this.currentScope);
    }

    @Override
    public void exitCombineStmt(SplcParser.CombineStmtContext ctx) {
        this.currentScope = this.currentScope.getParent();
    }
Visitor设计方式: Visitor 针对大括号内部所有的statement并不是自动调用,而是手动调用方式,因此要这样设计:
@Override
    public Void visitCombineStmt(SplcParser.CombineStmtContext ctx) {
        this.currentScope = new Scope(currentScope);
        for (int i = 0; i < ctx.statement().size(); i++) {
            visit(ctx.statement(i));
        }
        this.currentScope = this.currentScope.getParent();
        return null;
    }
2. 获取变量基本类型
SPLC 的类型不是一个 TYPE token,而是三个独立的关键字备选:
对于带备选分支的规则,只有走到的分支对应的 token 方法才有内容,其余为 null。因此用一个辅助方法把它映射成 PrimitiveType:
这里,对于数组元素的 基本数据类型 ,依旧是 INT | CHAR 这两种类型之一。后面第4部分,会进一步介绍数组元素的类型该如何获取。
private Type resolveType(SplcParser.SpecifierContext ctx) {
    if (ctx.INT() != null) {
        return PrimitiveType.INT;
    } else if (ctx.CHAR() != null) {
        return PrimitiveType.CHAR;
    } else {
        return PrimitiveType.VOID;
    }
}
3. 获取变量名称
数组声明符文法为:
它有两个分支,可能定义数组。比如 x[1][2][3] 对应的语法树最外层是 varDec [3],其次是varDec [2] , 最内层才是 Identifier [1]。
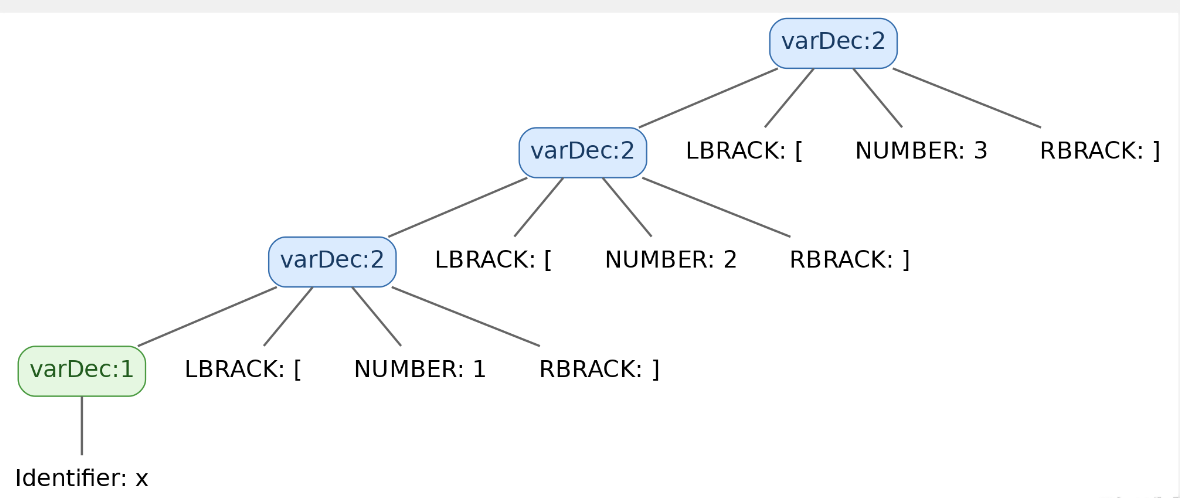
要拿到变量名,必须递归到最底层的 varDec。判断方法:如果当前层存在 Identifier,说明已经到达最底层;否则继续向下取 varDec()。
private String getVarName(SplcParser.VarDecContext ctx) {
    if (ctx.Identifier() != null) {
        return ctx.Identifier().getText();
    } else {
        // varDec LBRACK NUMBER RBRACK
        return getVarName(ctx.varDec());
    }
}
这里的逻辑就是:如果当前层没有解析到 Identifier,就一直向下递归解析,直到找到存在的 Identifier 为止。
4. 获取变量类型(数组层层包裹)
首先,ArrayType 内部定义需要有两个属性:
到这里聪明的你肯定也看出来了,我们之前只解析 specifier 来获取变量类型的操作是不准确的,因为很有可能这个变量是一个数组类型。所以我们要一个对应的逻辑去解析真正的变量类型。
// varDec: int a[1][2][3] -> type: int[3][2][1]
private Type getVarType(Type baseType, SplcParser.VarDecContext ctx) {
    // If it is not an array type:return the baseType.
    if (ctx.Identifier() != null) {
        return baseType;
    }

    // 1. Collect dimensions downward from the root node of the syntax tree:
    List<Integer> dims = new ArrayList<>();
    SplcParser.VarDecContext p = ctx;
  // The elements in dims are [3, 2, 1]
    while (p.Identifier() == null) {
        dims.add(Integer.parseInt(p.NUMBER().getText()));
        p = p.varDec();
    }

    // 2. Wrap sequentially
    // Origninal: t = int
    // After first loop:  t = array(int, 3)
    // After second loop: t = array(array(int, 3), 2)
    // After third loop:  t = array(array(array(int, 3), 2), 1) (toString int[3][2][1])
    Type t = baseType;
    for (int d : dims) {
        t = new ArrayType(t, d);
    }
    return t;
}
该函数的逻辑如下:
首先,判断当前类型是否为基本参数类型。如果是,则直接返回该基本类型;否则,说明这是一个数组类型,我们需要收集其维度信息。
注意:维度信息的收集顺序是从外到内的 。例如,在 C 语言中,声明 int x[1][2][3] 实际表示的类型是 array(array(array(int, 3), 2), 1),其结构为:
-
外层:长度为 1 的数组,元素类型是
int[3][2]; -
次内层:长度为 2 的数组,元素类型是
int[3]; -
最内层:长度为 3 的数组,元素类型是
int。
后续我们需要根据收集到的维度信息逐层构建最终的数组类型。这个构建过程本质上是一个 层层包裹 的过程:
- 从最内层开始 :最内层的数组元素类型就是传入的
basetype,而它的长度对应的是 最外层的维度值 (即dims数组中的第一个元素)。将这两者结合,得到当前层的数组类型,并更新变量t。 - 接着构建外层 :下一层的数组,其元素类型就是上一步构建出的 内层数组 ,而长度则取自
dims数组中的下一个值(即从右往左数的第二个维度,例如 2)。
对于更高维的数组,解析原理完全相同:每一层的元素类型是上一层构建的结果,而长度则依次取自 dims 数组中的后续元素—— 这个顺序与数组声明中从右到左的维度顺序一致 。
特别提醒 :在语法树中,ID 与数组维度的结合顺序与实际声明顺序是相反的 。
-
从 Identifier 沿父链向上看,维度依次是 1、2、3,与书写顺序一致;
-
而 getVarType 从根向叶收集,得到的是 3、2、1,与书写顺序相反。
5. 登记变量并检查重复定义
现在,我们已经有了获取类型和参数名称的函数。接下来要做的就是解析每个变量,并把解析完成的变量放进符号表中。
需要注意的是,我们的语法支持一次性定义多个变量,所以必须对每个定义的变量都执行相同的操作。
5.1 全局变量
全局变量/数组定义位于 globalDef 中、且没有花括号(函数定义才有 LBRACE 与 RBEACE):
        @Override
    public void enterGlobalDef(SplcParser.GlobalDefContext ctx) {
        if (ctx.LBRACE() != null && ctx.RBRACE() != null) {
            visitFuncDef(ctx);
        } else {
            visitVariableDec(ctx);
        }
    }
    //Variable Declare:
    private void visitVariableDec(SplcParser.GlobalDefContext ctx) {
        Type baseType = resolveType(ctx.specifier());
        SplcParser.VarDecContext varDec = ctx.varDec();
        TerminalNode identifierNode = getVarIdentifier(varDec);
        String name = identifierNode.getText();
        Type type = getVarType(baseType, varDec);
        if (this.globalScope.lookupCurrentVariable(name) != null) {
            errors.add(SplcSemanticError.redefinition(identifierNode));
        }else{
            this.globalScope.defineVariable(name, type);
        }
    }

      private void visitFuncDef(SplcParser.GlobalDefContext ctx) {
        Type returnType = resolveType(ctx.specifier());
        String name = ctx.Identifier().getText();
        if (globalScope.lookupFunction(name) == null) {
            globalScope.defineFunction(name, returnType, new ArrayList<>());
            currentScope = globalScope.lookupFunction(name);//renew current scope
        } else {
            errors.add(SplcSemanticError.redeclaration(ctx.Identifier()));
            return;
        }
        //todo: to do check function parameters:

    }
5.2 局部变量
对应g4文件:
globalDef
    : specifier Identifier LPAREN funcArgs RPAREN LBRACE statement* RBRACE      // 函数定义
    | specifier varDec SEMI                                                  // 全局变量定义
    ;
statement
    : LBRACE statement* RBRACE                                      # CombineStmt
    | specifier varDec (ASSIGN expression)? SEMI                    # LocalVariableStmt
    | RETURN expression SEMI                                        # ReturnStmt
    | expression SEMI                                               # ExpressionStmt
    ;
SPLC 的局部变量声明在带标签的 # LocalVariableStmt 中,且一条语句只有一个声明符):
    @Override
    public void enterLocalVariableStmt(SplcParser.LocalVariableStmtContext ctx) {
        Type baseType = resolveType(ctx.specifier());
        SplcParser.VarDecContext varDec = ctx.varDec();

        TerminalNode varIdentifier = getVarIdentifier(varDec);
        String name = varIdentifier.getText();
        Type type = getVarType(baseType, varDec);
        // defineVariable(name, type),if redeclaration of name, return null
        VariableSymbol result = this.currentScope.defineVariable(name, type);

        if (result == null) {
            errors.add(SplcSemanticError.redeclaration(varIdentifier));
            return;
        }
        // todo: Check type compatible of left and right.
        // int a = 'c';  // ok
        // int a[1][2] = 1; // error
    }
Listener 与Visitor 访问局部变量的区别
在Listener的框架中,enterLocalVariableStmt 这类方法是自动调用的,但是在 Visitor 的框架中,他们并非自动调用,需要我们手动调用。 因此,在下面的方法结束前,
需要手动加上这个for循环
小结
通过上面的例子,我们完成了:
- 进入/退出作用域(
CombineStmt,函数体则在globalDef中处理); - 用
resolveType把INT/CHAR/VOID关键字映射成基本类型; - 用
getVarName递归取到数组变量名; - 用
getVarType按语法树维度层层包裹出ArrayType; - 调用
Scope.defineVariable登记变量,并在返回null时报告重复定义。
好了,现在我们已经通过一个例子完成了变量的定义,并在定义时检查了是否重复定义。相信你已经明白如何通过符号表和 Listener 来进行符号检查。接下来的工作可以自己尝试完成。
练习
在前一阶段符号表的基础上,以及基于本次实验上述介绍的内容,继续完成下列语义分析功能:
解读数组类型:能够解析 varDec 中的多维数组声明,构造正确的 ArrayType,并按规定格式输出。
**解读花括号语句 # CombineStmt ** :每一对 { ... } 构成一个新作用域,支持变量遮蔽(shadowing)。
类型匹配检查 :数组类型不能被整体赋值(不能用一个标量值直接赋给一个未带下标的数组变量)。
错误的输出格式与错误种类沿用上一章练习。
Part A:
由于本次Lab的介绍基于Listener,请先实现 SyntaxListener.java
Part B:
在实现 SyntaxListener.java 的基础上,完成 SyntaxVisitor.java
测试用例:
测试1: 正确定义数组
输出:
测试2: 变量名重复
输出:
测试3: {}语句块的正确代码
输出:
测试4: 数组类型赋值不匹配错误
int x;
int main(){
    int a = 5;
    int b = 6;
    int c[3][2][1];
    char d[1][2];
    {
        int x = 7;
        a = 5;
        {
            b = 2;
            x = 8;
        }
        x = 'c';
        c = 1;
        d = 'h';
        int z = 'd';
        char k = 1;
    }
    x = 10;
}
输出: